令和3年度 春期 応用情報技術者試験 午後 問題 問6 経営分析システムにおけるスタースキーマ設計とSQL文の作成
テクノロジデータベース
学習ガイド
カーシェアリングサービスの運営状況を多角的に把握するための経営分析システムを構築するデータベース問題です。既存の貸出管理システムをデータソースとした業務要件の実現性評価や、多次元データベースのデータモデル設計、データ加工用のSQL文の作成が問われます。分析の軸となるディメンション表と実績を記録するファクト表の関係を整理し、複雑な条件指定やテーブル結合を含むSQL文の組み立て方を順番に解説します。
この記事で押さえる論点
- 貸出管理システムのデータソースから、業務要件の実現可能性を評価し不可能な要件を判別できる
- 多次元データベースにおけるスタースキーマ構造(ファクト表とディメンション表)を設計できる
- 複数の表を結合(INNER JOIN)し、適切な単位で集計(GROUP BY)を行うSQL文を記述できる
出題情報
- 出題
- 2021(R3)春 応用情報技術者 午後 問6
- 配点
- 20点満点
- 模範解答
- 公表(設問ごとに掲載)
出題趣旨・採点講評(IPA 公表)
昨今のディジタル革新の取組によって,SoI(Systems of Insight)のシステム領域で取り扱うデータの量・種類の増加や質の多様化が進んでおり,データ資源を適切に管理するデータエンジニアの重要性が増している。本問では,MaaS事業者の経営分析システム構築を題材として,SoIにおいてデータエンジニアに求められるデータベース設計及びデータ操作に必要な知識の基本的な理解並びにデータモデリングの能力について問う。
問6では,MaaS事業者の経営分析システム構築を題材に,SoI(Systems of Insight)において必要となるデータベース設計及びデータ操作について出題した。全体として正答率はやや低かった。
問題本文
経営分析システムのためのデータベース設計に関する次の記述を読んで,設問1〜4に答えよ。
P社は,個人向けのカーシェアリングサービスを運営する MaaS(Mobility as a Service)事業者である。シェアリングのニーズが高い大都市の地区を中心に,500駐車場で約 2,000 台の自動車(以下,車両という)を貸し出している。P社には本社のほかに,各地区でのサービス運営を担当する支社が 10 社ある。本社はサービス全体を統括しており,新サービスの企画やマーケティングなどを行っている。支社は貸出管理システムを用いて現場で車両の貸出管理業務を行っている。
本社では,サービス運営状況を多角的な観点でタイムリーに把握して,適切な意思決定を行うために,貸出管理システムのデータをソースとする経営分析システムを構築することになった。本社の情報システム部のQさんはデータエンジニアに任命され,データサイエンティストであるRさんとプロジェクトを推進することになった。
〔データソースの調査〕
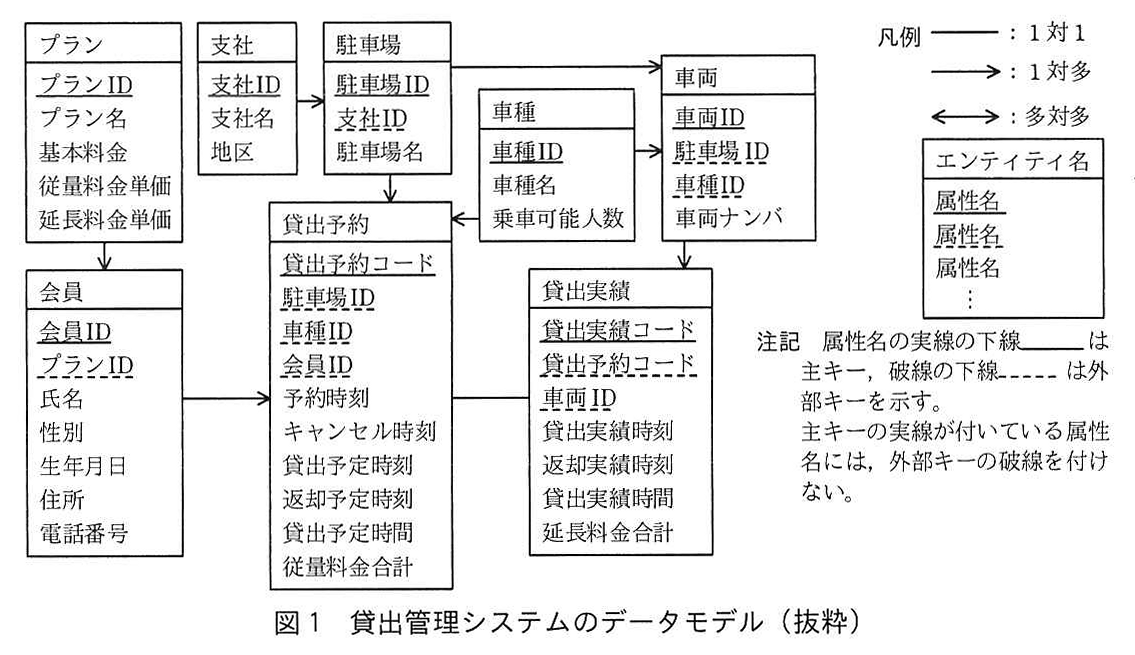
貸出管理システムには,貸出予約及び貸出実績のデータが過去 5 年間分蓄積されている。貸出管理システムのデータモデルの抜粋を図1に示す。
図の説明テキスト
図1 貸出管理システムのデータモデル(抜粋)
ER図。凡例として、実線は1対1、片方向矢印は1対多、両方向矢印は多対多を表す。属性の実線の下線は主キー、破線の下線は外部キーを示す。主キーの実線が付いている属性名には、外部キーの破線を付けない。
エンティティと属性(PK:主キー, FK:外部キー):
- プラン: プランID(PK), プラン名, 基本料金, 従量料金単価, 延長料金単価
- 支社: 支社ID(PK), 支社名, 地区
- 駐車場: 駐車場ID(PK), 支社ID(FK), 駐車場名
- 車種: 車種ID(PK), 車種名, 乗車可能人数
- 車両: 車両ID(PK), 駐車場ID(FK), 車種ID(FK), 車両ナンバ
- 会員: 会員ID(PK), プランID(FK), 氏名, 性別, 生年月日, 住所, 電話番号
- 貸出予約: 貸出予約コード(PK), 駐車場ID(FK), 車種ID(FK), 会員ID(FK), 予約時刻, キャンセル時刻, 貸出予定時刻, 返却予定時刻, 貸出予定時間, 従量料金合計
- 貸出実績: 貸出実績コード(PK), 貸出予約コード(FK), 車両ID(FK), 貸出実績時刻, 返却実績時刻, 貸出実績時間, 延長料金合計
リレーションシップ(1対多は「1側 → 多側」で表記):
- プラン → 会員
- 支社 → 駐車場
- 駐車場 → 貸出予約
- 駐車場 → 車両
- 車種 → 貸出予約
- 車種 → 車両
- 会員 → 貸出予約
- 貸出予約 ― 貸出実績 (1対1)
- 車両 → 貸出実績
利用希望者はあらかじめP社の会員になり,いずれかのプランに加入しておく必要がある。プランごとに基本料金(月額),従量料金及び延長料金(いずれも 10 分単位)の単価が決まっている。会員が車両を借りたいときは,P社のホームページで借りたい日時や駐車場,車種などを選択し,貸出を予約する。貸出や返却の実績時刻が予約時の内容と異なる場合であっても,貸出予約の情報は修正しない。従量料金合計は予約時に指定された貸出予定時間を基に算出する。予約時に指定した返却予定時刻より早い時刻に返却しても,従量料金合計は減算しない。予約時に指定した返却予定時刻より遅い時刻に返却した場合は遅延返却として扱う。遅延返却は後の時間帯に予約している別の会員の迷惑となるので,超過した時間については従量料金よりも高い延長料金によって延長料金合計を算出する。これによって,遅延返却の発生件数(以下,遅延返却発生件数という)の低減を図っている。毎月末に当月の基本料金,従量料金合計及び延長料金合計を合算して,翌月に会員に請求する。
貸出管理システムのデータベースでは,データモデルのエンティティ名を表名にし,属性名を列名にして,適切なデータ型で表定義した関係データベースによって,データを管理している。時刻はTIMESTAMP型,年月日はDATE型で定義されている。
また,P社ではKPIの一つとして車両稼働率を重視している。車両稼働率とは,各車両における 1 日当たりの貸出実績時間の割合である。平均車両稼働率の目標データは,表計算ソフトのデータとして,年月日別・駐車場別・車種別に過去 3 年間分が蓄積されており,それ以前のデータは破棄されている。
〔業務要件の把握〕
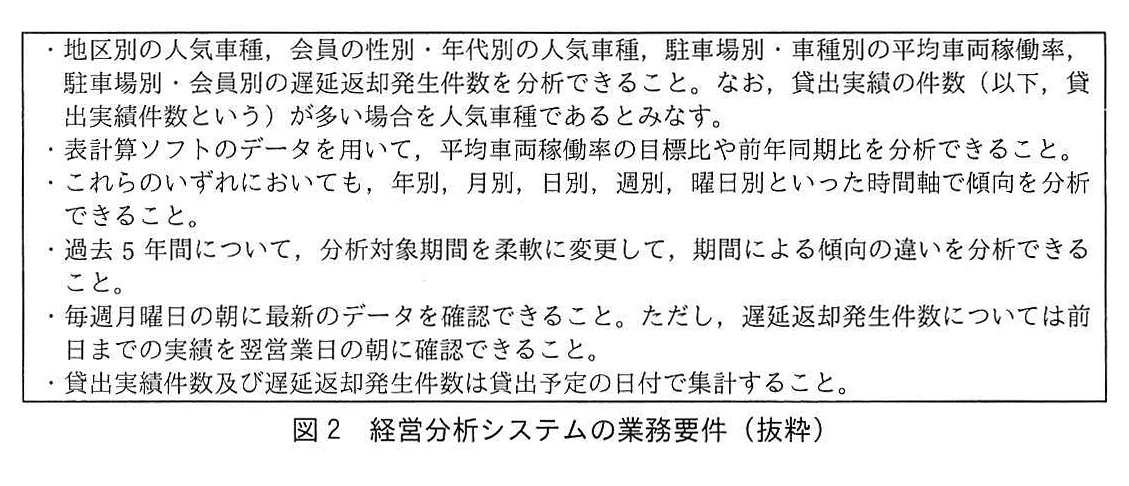
P社の経営企画部では,車両の追加整備計画の立案を検討している。Rさんは経営企画部にヒアリングを行い,経営分析システムの業務要件を把握した。業務要件の抜粋を図2に示す。
Qさんは,データソースの調査結果を踏まえて,図2の業務要件の実現可能性を評価した。その結果,①業務要件の一部は経営分析システムの運用開始直後には実現できないことが判明した。対応方針を経営企画部と協議した結果,業務要件は変更せず,運用開始直後の分析は,実現可能な範囲で行うことで合意した。
図の説明テキスト
図2 経営分析システムの業務要件(抜粋)
・地区別の人気車種、会員の性別・年代別の人気車種、駐車場別・車種別の平均車両稼働率、駐車場別・会員別の遅延返却発生件数を分析できること。なお、貸出実績の件数(以下、貸出実績件数という)が多い場合を人気車種であるとみなす。
・表計算ソフトのデータを用いて、平均車両稼働率の目標比や前年同期比を分析できること。
・これらのいずれにおいても、年別、月別、日別、週別、曜日別といった時間軸で傾向を分析できること。
・過去5年間について、分析対象期間を柔軟に変更して、期間による傾向の違いを分析できること。
・毎週月曜日の朝に最新のデータを確認できること。ただし、遅延返却発生件数については前日までの実績を翌営業日の朝に確認できること。
・貸出実績件数及び遅延返却発生件数は貸出予定の日付で集計すること。
〔経営分析システムのデータモデル設計〕
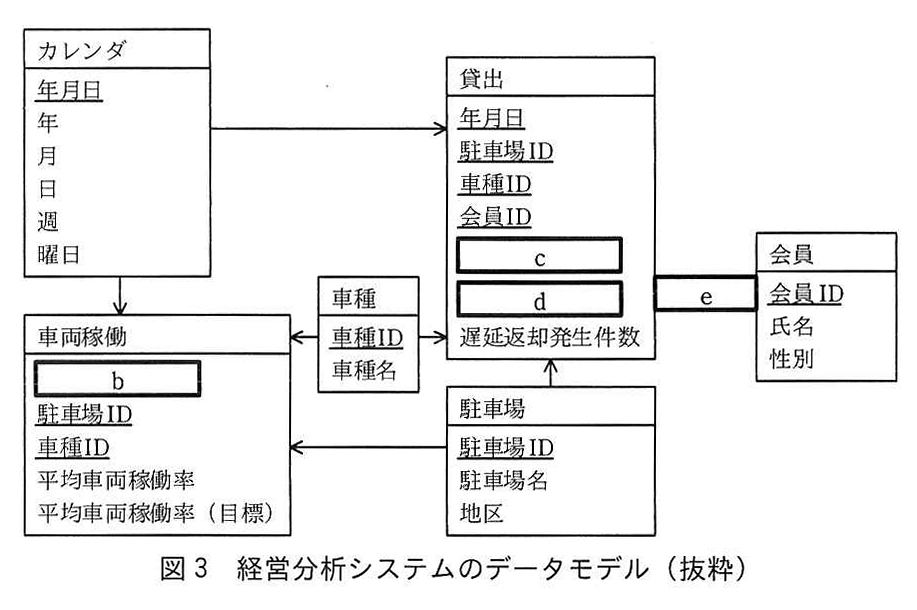
次に,Qさんは図2の業務要件を基に,経営分析システムのデータモデルを多次元データベースとして設計した。多次元データベースの実装には,データモデルのエンティティ名を表名にし,属性名を列名にして,適切なデータ型で表定義した関係データベースを用いることにした。列指向データベースは用いず,データを行単位で扱う行指向データベースを用いることにした。問合せの処理性能を考慮して,データモデルの構造にはa構造を採用した。経営分析システムのデータモデルの抜粋を図3に示す。
経営分析システムには,最長で過去5年間分のデータを蓄積することにした。
年月日の週と曜日は,事前に定義したSQLのユーザ定義関数を用いて取得できる。
図の説明テキスト
図3 経営分析システムのデータモデル(抜粋)
各エンティティ(表)の構成:
- カレンダ: 年月日(下線)、年、月、日、週、曜日
- 貸出: 年月日(下線)、駐車場ID(下線)、車種ID(下線)、会員ID(下線)、c、d、遅延返却発生件数
- 車両稼働: b、駐車場ID(下線)、車種ID(下線)、平均車両稼働率、平均車両稼働率(目標)
- 車種: 車種ID(下線)、車種名
- 駐車場: 駐車場ID(下線)、駐車場名、地区
- 会員: 会員ID(下線)、氏名、性別
リレーションシップ(矢印):
- 「カレンダ」から「貸出」へ矢印。
- 「カレンダ」から「車両稼働」へ矢印。
- 「車種」から「貸出」へ矢印。
- 「車種」から「車両稼働」へ矢印。
- 「駐車場」から「車両稼働」へ矢印。
- 「駐車場」から「貸出」へ矢印。
- 「貸出」と「会員」の間は e の枠でつながっている(関連の記号が空欄)。
〔データ加工処理の開発〕
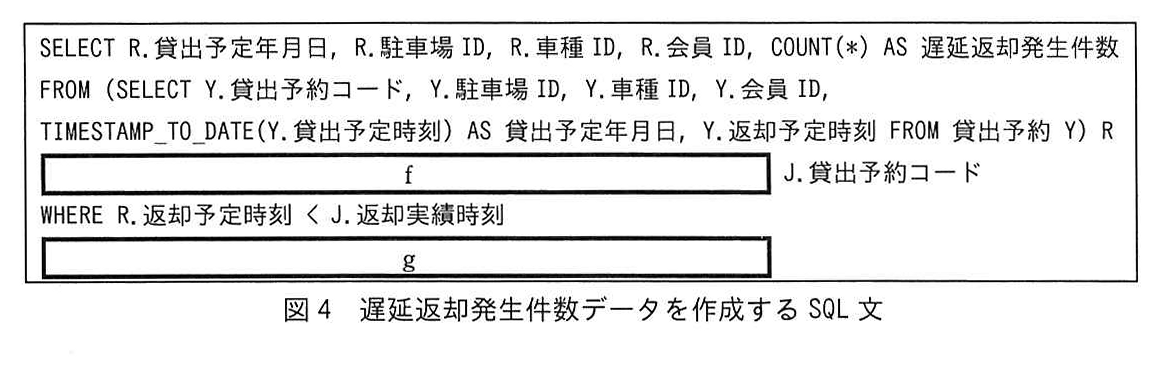
貸出管理システムのデータベースから経営分析システムのデータベースへのデータ連携時に,一部のデータを加工する必要がある。Qさんは,データ加工処理用のデータベースを用意し,データ加工を行うバッチ処理プログラムを開発した。図4のSQL文は,そこで用いられている図3の貸出表の遅延返却発生件数データを作成するためのものである。ここで,TIMESTAMP_TO_DATE関数は,指定されたTIMESTAMP型の時刻をDATE型の年月日に変換するユーザ定義関数である。
バッチ処理プログラムでは,図4のSQL文で作成したデータを貸出表に挿入する際,遅延返却発生件数が0件のレコードに対する処理も別途行うようになっている。
図の説明テキスト
図4 遅延返却発生件数データを作成する SQL 文
枠内に以下のSQL文が記述されている。
SELECT R.貸出予定年月日, R.駐車場 ID, R.車種 ID, R.会員 ID, COUNT(*) AS 遅延返却発生件数
FROM (SELECT Y.貸出予約コード, Y.駐車場 ID, Y.車種 ID, Y.会員 ID,
TIMESTAMP_TO_DATE(Y.貸出予定時刻) AS 貸出予定年月日, Y.返却予定時刻 FROM 貸出予約 Y) R
<span id="q6_blank_f" class="blank-label">f</span> J.貸出予約コード
WHERE R.返却予定時刻 < J.返却実績時刻
<span id="q6_blank_g" class="blank-label">g</span>
〔分析のレスポンス性能の改善〕
性能検証を実施したところ,分析対象期間を過去複数年間,時間軸を月別として人気車種及び遅延返却発生件数を分析する場合,種々の分析に時間が掛かり過ぎるので改善してほしいという要望が経営企画部から挙がった。経営分析システムのデータベースのインデックスは既に適切に作成している。分析のレスポンス性能を改善するために,Qさんは②データマートとして集計表を追加した。
設問と解答・解説
設問1
本文中の下線①について,実現できない業務要件を40字以内で具体的に答えよ。
模範解答
システム稼働後2年間は,過去5年間分の平均車両稼働率の目標比を表示できない。
採点基準
- 3点: 「過去5年間分の平均車両稼働率の目標比」が「システム稼働後2年間」は表示(分析)できないことが明記されている。
- 2点: 不足しているデータ(過去5年分の目標データなど)については言及しているが、期間(2年間)の記述がない、または不正確である。
- 1点: 分析できないという結論のみであり、具体的なデータ名や期間が示されていない。
- 0点: 業務要件の実現可能性の評価として的外れな記述となっている。
- 2点: 期間と実現できない機能が明確に関連付けられ、論理的に記述されている。
- 1点: 事実の羅列にとどまり、論理的な繋がりがやや不明確である。
- 0点: 論理構造が破綻しており、文意が読み取れない。
解説
解説
- 図2 経営分析システムの業務要件(抜粋) には、「表計算ソフトのデータを用いて、平均車両稼働率の目標比や前年同期比を分析できること。」および「過去5年間について、分析対象期間を柔軟に変更して、期間による傾向の違いを分析できること。」という要件がある。
- 一方、〔データソースの調査〕 によると、「平均車両稼働率の目標データは、表計算ソフトのデータとして、年月日別・駐車場別・車種別に過去3年間分が蓄積されており、それ以前のデータは破棄されている。」と記載されている。
- したがって、経営分析システムの運用開始直後には、平均車両稼働率の目標データは過去3年間分しか存在しない。
- 業務要件の「過去5年間について」目標比を分析できるようになるには、運用開始から新たに2年間分のデータを蓄積する必要がある。
- このことから、運用開始直後に実現できないのは「システム稼働後2年間は、過去5年間分の平均車両稼働率の目標比を表示(分析)すること」であると導出できる。
高得点のポイント
- 実現できない対象が「過去5年間分の平均車両稼働率の目標比」であること
- 実現できない期間が「システム稼働後2年間」であることを明記していること
設問1は,正答率が平均的であった。業務部門の要件に対して必要なデータが不足していることは現実によくある問題なので,データソースを注意深く精査してほしい。
設問2
〔経営分析システムのデータモデル設計〕について,(1),(2)に答えよ。
本文中のaに入れる適切な字句を解答群の中から選び,記号で答えよ。
模範解答
選択肢ウ: スタースキーマ
解説
解説
- 〔経営分析システムのデータモデル設計〕 において、データモデルの構造には関係データベースを用いた多次元データベースが設計されている。
- 図3 経営分析システムのデータモデル(抜粋) を見ると、分析の対象となる事実データを保持するファクト表(「貸出」表、「車両稼働」表)を中心に配置し、その周囲に分析の切り口となるディメンション表(「カレンダ」「車種」「駐車場」「会員」)を配置した構造になっている。
- このように、関係データベースを用いて多次元分析を行うためのモデルとして、中心のファクト表から放射状にディメンション表を配置する構造を スタースキーマ と呼ぶ。
- したがって、a には「スタースキーマ」が当てはまる。
各選択肢の解説
- ア: 3層スキーマは、データベースアーキテクチャを外部スキーマ・概念スキーマ・内部スキーマの3階層で捉えるモデルであり、多次元データベースの構造ではない。
- イ: オブジェクト指向は、データと処理を一体化して扱う概念であり、関係データベースにおける多次元データモデルの構造名ではない。
- エ: スノーフレークスキーマは、スタースキーマのディメンション表を正規化した構造である。図3では「駐車場」表に「地区」が含まれるなど正規化されていないため不適切。
- オ: 第3正規形は、データの重複や矛盾を排除するためのトランザクション処理向けの正規化レベルであり、分析用の多次元データモデル構造ではない。
- カ: 非正規形は、正規化が全く行われていない状態を指す用語であり、スタースキーマ全体を表す名称ではない。
模範解答
年月日
年代
貸出実績件数
←
採点基準
- 2点: 次の4つがすべて正しい:b「年月日」、c・d「年代」と「貸出実績件数」(c/dは順不同。どちらの欄にどちらを書いてもよいが、同じ属性を2回書いたものは1つ分しか数えない)、e「←」(会員を1側・貸出を多側とする1対多の矢印。図3では貸出が左・会員が右なので左向き。「会員から貸出への1対多の矢印」のように向きを言葉で示したものも可)。
- 1点: 4つのうち2〜3つが正しい。
- 0点: 正しいものが1つ以下。
- 1点: 図1の凡例・注記に従った表記(e を矢印で示し、両方向矢印や線のみにしていない。属性名は「年代」「貸出実績件数」の字句)。b の実線の下線(主キー)は入力欄で表せないので「年月日(主キー)」等の明記を推奨し、「年月日」だけでも減点しない。
- 0点: 凡例と異なる表記。
解説
解説
- bについて
- 図3 の「車両稼働」表には、「カレンダ」表から矢印が引かれており、外部キーが存在するはずである。
- すでに「駐車場ID」と「車種ID」は主キーの一部として定義されているため、残りの主キーかつ「カレンダ」表の主キーである「年月日」が入る。公式解答例では年月日に主キーを示す実線の下線が付く(図3の b の枠には下線がない)。
- c, dについて
- 図2 の業務要件には「会員の性別・年代別の人気車種」「貸出実績の件数(以下、貸出実績件数という)が多い場合を人気車種であるとみなす」とある。
- 「貸出」表(図3)でこれらを集計するために必要な属性が入る。会員の性別は「会員」表にあるが、「年代」に該当する属性がない(貸出管理システムの会員表(図1)には生年月日がある)。そのため「貸出」表に「年代」を持たせる必要がある。
- さらに、人気車種の判定に必要な「貸出実績件数」を集計する属性が必要である。(遅延返却発生件数はすでに存在する)
- よって、cとdには「年代」「貸出実績件数」が入る(順不同)。
- eについて
- 図1 の凡例によると、1対多の関連は「1側 多側」で表現される。
- 会員1人に対して複数の貸出実績が存在するため、「会員」と「貸出」の関連は「会員」が1側、「貸出」が多側となる。
- 図3 の配置では右側に「会員」、左側に「貸出」があるため、1側から多側へ向かう矢印は左向きの「」となる。
高得点のポイント
- 車両稼働表の主キーとして「年月日」を正しく導出できていること
- 業務要件から貸出表に必要な属性として「年代」と「貸出実績件数」を特定できていること
- 図の凡例とエンティティの配置関係から、適切な向きの矢印(
←)を導出できていること
設問2(1)は,正答率が低かった。スタースキーマは,関係データベースを用いて多次元データベースを実装する際に有用なデータモデルの構造なので,十分に理解してほしい。
設問3
〔データ加工処理の開発〕について,(1),(2)に答えよ。
模範解答
INNER JOIN 貸出実績 J ON R.貸出予約コード =
GROUP BY R.貸出予定年月日, R.駐車場ID, R.車種ID, R.会員ID
採点基準
- 2点: fが「INNER JOIN 貸出実績 J ON R.貸出予約コード =」(INNERを省いたJOINも可。直後にJ.貸出予約コードが続くので末尾は「R.貸出予約コード =」で終わる。相関名JはWHERE句のJ.返却実績時刻から決まる)、かつgが「GROUP BY R.貸出予定年月日, R.駐車場ID, R.車種ID, R.会員ID」(4列の並び順・空白の有無は問わない)である。
- 1点: fとgの一方だけ正しい、又は両方ほぼ正しいが列の過不足・相関名の欠落が1か所ある。
- 0点: それ以外。
- 1点: fとgを区別して答え、列名に相関名(RやJ)を付けている。
- 0点: 相関名がない、又はfとgの区別がない。
解説
解説
- 図4 は遅延返却発生件数データを作成するSQL文である。
- fについて
- 遅延返却の判定条件は「返却予定時刻 返却実績時刻」である。
- 返却予定時刻は「貸出予約」表(相関名
Yを持つサブクエリR)にあり、返却実績時刻は「貸出実績」表にある。 - この2つの表を結合する必要がある。結合条件は両表に共通する
貸出予約コードである。 fの後にJ.貸出予約コードと続くことから、fにはINNER JOIN 貸出実績 J ON R.貸出予約コード =が入る。
- gについて
- SELECT句では、
R.貸出予定年月日,R.駐車場 ID,R.車種 ID,R.会員 IDを抽出するとともに、COUNT(*)で件数を集計している。 - 集計関数を使用し、特定の列ごとにグループ化するためには GROUP BY 句が必要となる。
- したがって
gには、SELECT句の集計対象外の列を指定するGROUP BY R.貸出予定年月日, R.駐車場 ID, R.車種 ID, R.会員 IDが入る。(スペース等の表記揺れは許容される)
- SELECT句では、
高得点のポイント
- f: 貸出実績表(相関名J)とのINNER JOINの構文を正確に記述できていること
- g: SELECT句の列に対応するGROUP BY句を正確に記述できていること
図4のSQL文を実行するべき頻度を2字以内で答えよ。
模範解答
日次
採点基準
- 1点: 「翌営業日の朝に確認」という要件から「日次」という頻度を正しく導き出している。
- 0点: 誤った頻度を回答している。
- 1点: 業務要件とシステム処理の関係を論理的に結びつけている。
- 0点: 論理的な結びつきが読み取れない。
解説
解説
- 図2 経営分析システムの業務要件(抜粋) の5つ目の項目に、「毎週月曜日の朝に最新のデータを確認できること。ただし、遅延返却発生件数については前日までの実績を翌営業日の朝に確認できること。」と記載されている。
- 図4 のSQL文は、遅延返却発生件数データを作成するための処理である。
- 要件である「前日までの実績を翌営業日の朝に確認」を満たすためには、少なくとも毎日データを加工し、更新する必要がある。
- したがって、図4のSQL文を実行するべき頻度は「日次」となる。
高得点のポイント
- 業務要件から遅延返却発生件数の更新頻度を読み取り、「日次」であることを正しく導出できていること
設問3(1)のfは,正答率がやや低かった。結合は基本的なデータ操作の一つなので構文を理解してほしい。
設問4
本文中の下線②について,追加した集計表の主キーを答えよ。
模範解答
年月,駐車場ID,車種ID,会員ID
採点基準
- 3点: 「年月」をキーとし、「駐車場ID」「車種ID」「会員ID」を適切に含めている。
- 2点: 「年月日」のままであるか、いずれかのIDが1つ欠けている。
- 1点: 複数のIDが欠けている、または不要な属性が含まれている。
- 0点: 全く的外れな回答。
- 2点: 業務要件の分析軸と整合性が取れた論理的な構成になっている。
- 1点: 構成は一部不正確だが、集計粒度を粗くするという論理は伺える。
- 0点: 論理的な構成になっていない。
解説
解説
- 〔分析のレスポンス性能の改善〕 の下線②について、目的は「分析対象期間を過去複数年間、時間軸を月別として人気車種及び遅延返却発生件数を分析する場合」のレスポンス時間を改善することである。
- 図3 の「貸出」表は、「年月日」「駐車場ID」「車種ID」「会員ID」を主キーとして日次レベルの細かい粒度でデータを保持している。
- 時間軸を「月別」として分析を行う場合、年や月ごとに数多くの日次レコードを集計する必要があるため時間がかかる。
- レスポンス性能を改善するためには、あらかじめ「月別」の粒度で集計したデータマート(集計表)を作成し、分析時にその表を参照するのが効果的である。
- 人気車種や遅延返却発生件数の分析軸(駐車場別、車種別、会員の性別・年代別など)を維持するため、「駐車場ID」「車種ID」「会員ID」はそのまま残し、「年月日」を「年月」という粗い粒度に変更する。
- したがって、追加する集計表の主キーは「年月,駐車場ID,車種ID,会員ID」となる。
高得点のポイント
- 時間軸の集計粒度を「年月日」から「年月」に変更できていること
- 分析に必要な軸である「駐車場ID」「車種ID」「会員ID」を主キーとして含めていること
設問4は,正答率が低かった。人気車種及び遅延返却発生件数の分析のレスポンス性能を改善するためには貸出表の集計表をデータマートとして作成する必要があるが,貸出表に着目していない解答が散見された。要望を実現するために必要なデータを明確にした上で,正答を導いてほしい。