令和3年度 春期 応用情報技術者試験 午後 問題 問3 k-means法によるクラスタ分析のアルゴリズムの理解
学習ガイド
2次元データを用いたk-means法によるクラスタ分析のアルゴリズムを読み解くプログラミング問題です。点とコアの距離計算から、クラスタの重心を求め、重心が変わらなくなるまで分類を繰り返す一連の手順が問われます。具体的な座標値を使った手計算のプロセスを追いかけながら、プログラム内の変数や配列がアルゴリズムのどの処理に該当しているかを確認し、初期設定を改良するロジックの意味を紐解きます。
この記事で押さえる論点
- k-means法におけるクラスタリングの手順(初期設定、距離計算、重心更新)をトレースできる
- 与えられた2次元の座標データを用いて、点とコアや重心との距離を計算できる
- より適切なコアを選ぶため、初期設定に確率的なアルゴリズムを組み込む改良案を説明できる
出題情報
- 出題
- 2021(R3)春 応用情報技術者 午後 問3
- 配点
- 20点満点
- 模範解答
- 公表(設問ごとに掲載)
出題趣旨・採点講評(IPA 公表)
近年,機械学習を利用したデータ分析が多く利用されている。本問では,データの分類に利用されるクラスタリングを行う手法の一つであるk-means法を題材として,クラスタリングのアルゴリズムの理解と,そのアルゴリズムの実装について問う。
問3では,クラスタリングを行う手法の一つであるk-means法を題材に,クラスタリングのアルゴリズムに関する理解と実装について出題した。全体として正答率は高かった。
問題本文
クラスタ分析に用いる k-means 法に関する次の記述を読んで,設問 1~3 に答えよ。
k-means 法によるクラスタ分析は,異なる性質のものが混ざり合った母集団から互いに似た性質をもつものを集め,クラスタと呼ばれる互いに素な部分集合に分類する手法である。新聞記事のビッグデータ検索,店舗の品ぞろえの分類,教師なし機械学習などで利用されている。ここでは,2次元データを扱うこととする。
〔分類方法と例〕
個の点を 個( 未満)のクラスタに分類する方法を(1)~(5)に示す。
(1) 個の点(1 から までの番号が付いている)からランダムに 個の点を選び(以下,初期設定という),それらの点をコアと呼ぶ。コアには 1 から までのコア番号を付ける。なお, 個のコアの座標は全て異なっていなければならない。
(2) 個の点と 個のコアとの距離をそれぞれ計算し,各点から見て,距離が最も短いコア(複数存在する場合は,番号が最も小さいコア)を選ぶ。選ばれたコアのコア番号を,各点が所属する 1 回目のクラスタ番号(1 から )とする。ここで,二つの点を XY 座標を用いて と とした場合, と の距離を で計算する。
(3) 個のクラスタのそれぞれについて,クラスタに含まれる全ての点を使って重心を求める。ここで,重心の X 座標をクラスタに含まれる点の X 座標の平均,Y 座標をクラスタに含まれる点の Y 座標の平均と定義する。ここで求めた重心の番号はクラスタの番号と同じとする。
(4) 個の点と各クラスタの重心(,…,)との距離をそれぞれ計算し,各点から見て距離が最も短い重心(複数存在する場合は,番号が最も小さい重心)を選ぶ。選ばれた重心の番号を,各点が所属する次のクラスタ番号とする。
(5) 重心の座標が変わらなくなるまで,(3)と(4)を繰り返す。
次の座標で与えられる 7 個の点を,この分類方法に従い,二つのクラスタに分類する例を図 1 に示す。
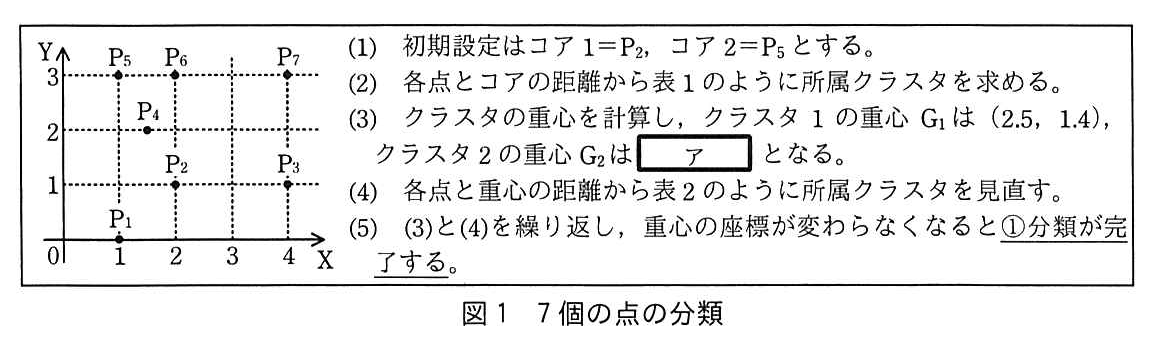
図の説明テキスト
図1 7個の点の分類。
左側にはX軸(0〜4)とY軸(0〜3)の座標系があり、7つの点(〜)がプロットされている。, , , , , , にプロットされている。
右側には手順(1)〜(5)がテキストで書かれている。
(1) 初期設定はコア1=,コア2=とする。
(2) 各点とコアの距離から表1のように所属クラスタを求める。
(3) クラスタの重心を計算し,クラスタ1の重心は,クラスタ2の重心はアとなる。
(4) 各点と重心の距離から表2のように所属クラスタを見直す。
(5) (3)と(4)を繰り返し,重心の座標が変わらなくなると①分類が完了する。
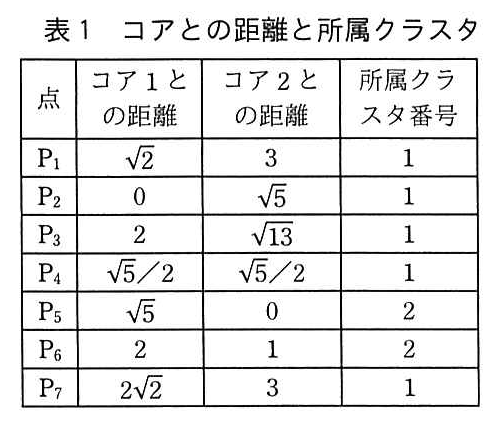
図の説明テキスト
表1 コアとの距離と所属クラスタ
| 点 | コア1との距離 | コア2との距離 | 所属クラスタ番号 |
|---|---|---|---|
| 3 | 1 | ||
| 0 | 1 | ||
| 2 | 1 | ||
| 1 | |||
| 0 | 2 | ||
| 2 | 1 | 2 | |
| 3 | 1 |
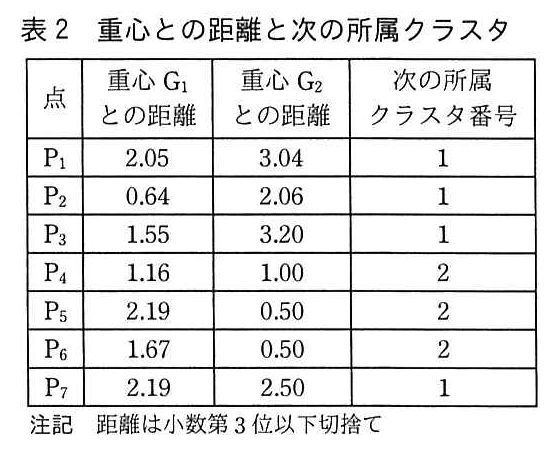
図の説明テキスト
表2 重心との距離と次の所属クラスタ
| 点 | 重心との距離 | 重心との距離 | 次の所属クラスタ番号 |
|---|---|---|---|
| 2.05 | 3.04 | 1 | |
| 0.64 | 2.06 | 1 | |
| 1.55 | 3.20 | 1 | |
| 1.16 | 1.00 | 2 | |
| 2.19 | 0.50 | 2 | |
| 1.67 | 0.50 | 2 | |
| 2.19 | 2.50 | 1 | |
| 注記: 距離は小数第3位以下切捨て |
〔クラスタ分析のプログラム〕
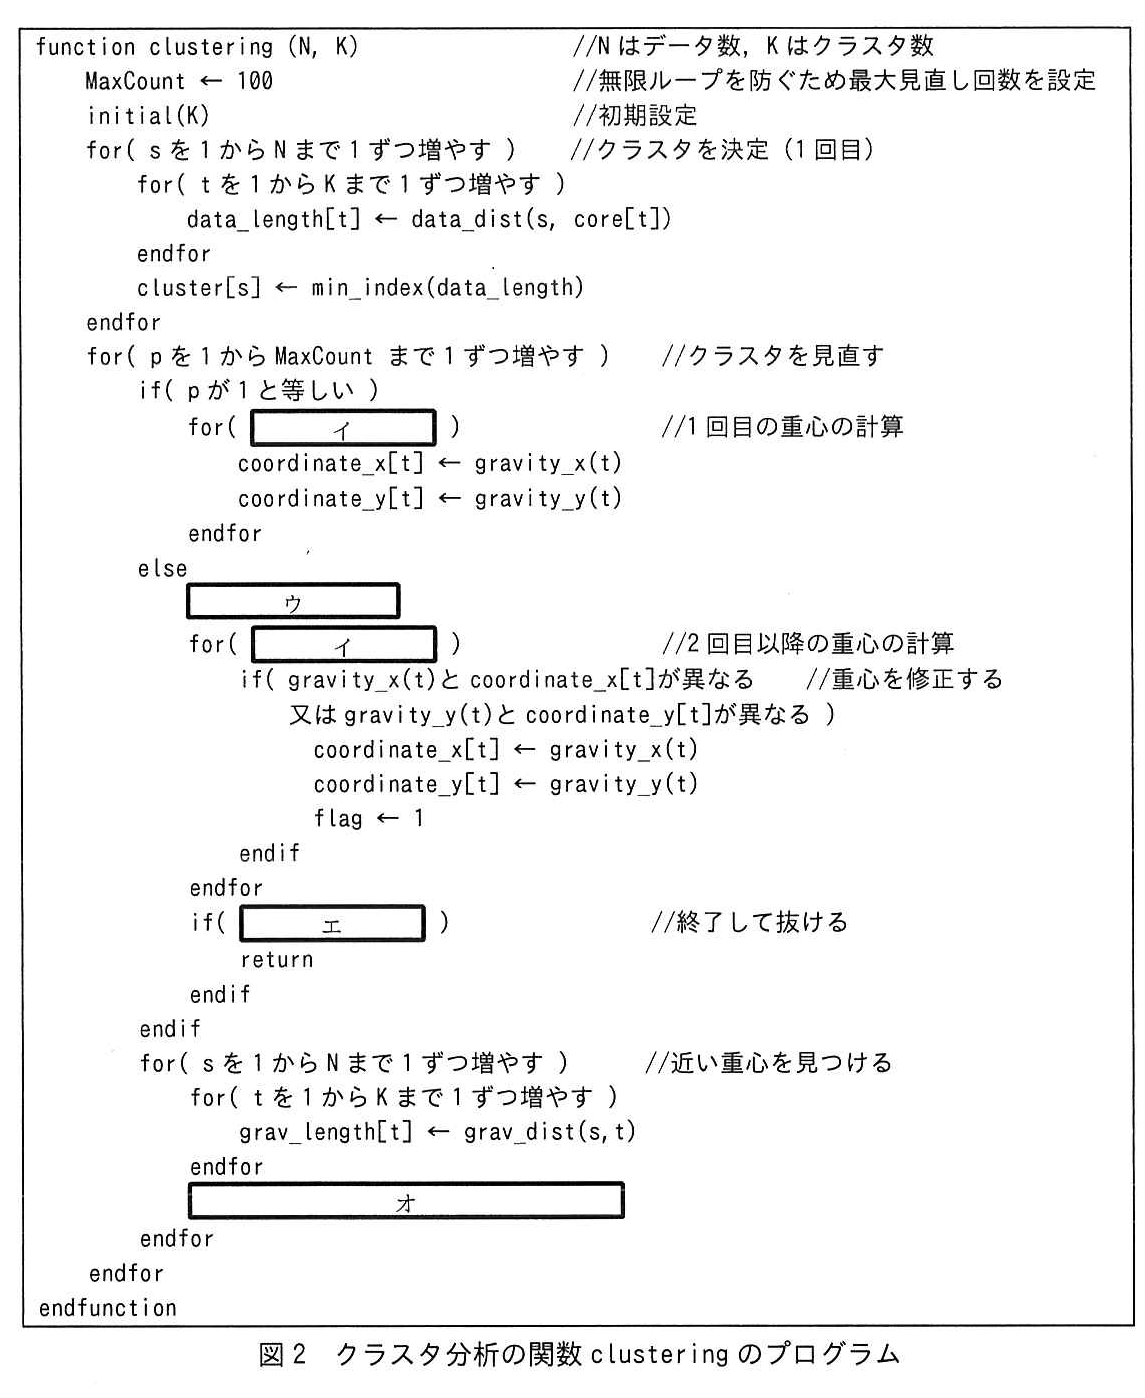
この手法のプログラムを図2に,プログラムで使う主な変数,関数及び配列を表3に示す。ここで,配列の添字は全て1から始まり,要素の初期値は全て0とする。
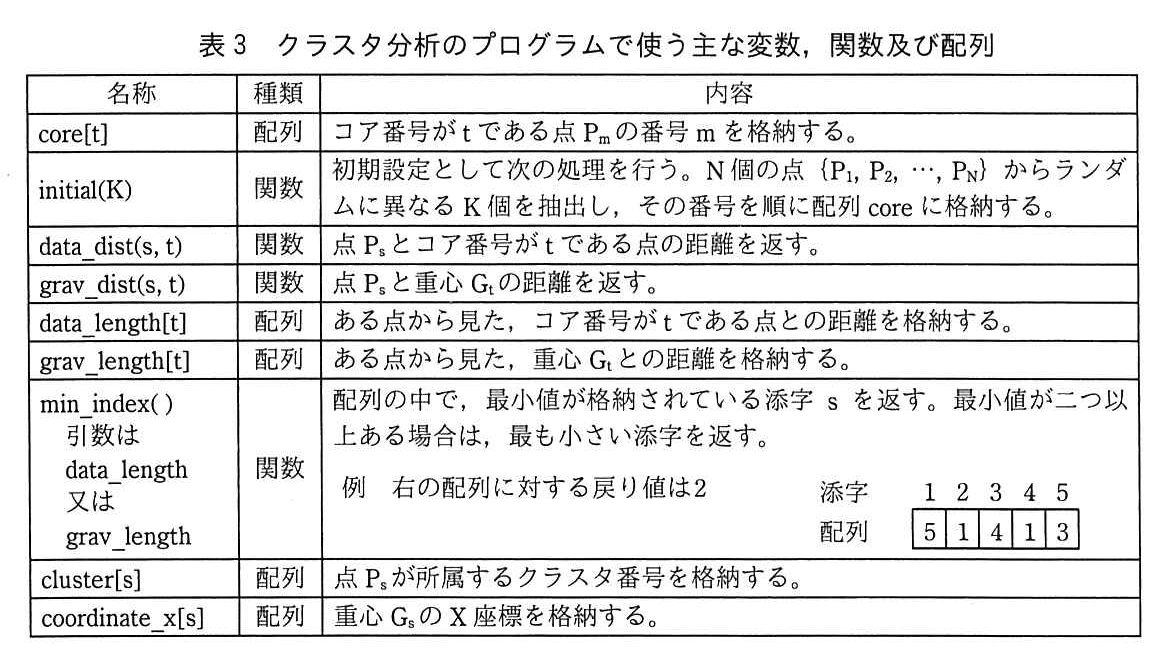
図の説明テキスト
表3 クラスタ分析のプログラムで使う主な変数,関数及び配列
| 名称 | 種類 | 内容 |
|---|---|---|
| core[t] | 配列 | コア番号がtである点の番号mを格納する。 |
| initial(K) | 関数 | 初期設定として次の処理を行う。N個の点 {, , …, } からランダムに異なるK個を抽出し,その番号を順に配列 core に格納する。 |
| data_dist(s, t) | 関数 | 点とコア番号がtである点の距離を返す。 |
| grav_dist(s, t) | 関数 | 点と重心の距離を返す。 |
| data_length[t] | 配列 | ある点から見た,コア番号がtである点との距離を格納する。 |
| grav_length[t] | 配列 | ある点から見た,重心との距離を格納する。 |
| min_index() (引数は data_length 又は grav_length) | 関数 | 配列の中で,最小値が格納されている添字sを返す。最小値が二つ以上ある場合は,最も小さい添字を返す。 例: 右の配列に対する戻り値は2 (添字: 1 2 3 4 5, 配列: 5 1 4 1 3) |
| cluster[s] | 配列 | 点が所属するクラスタ番号を格納する。 |
| coordinate_x[s] | 配列 | 重心のX座標を格納する。 |
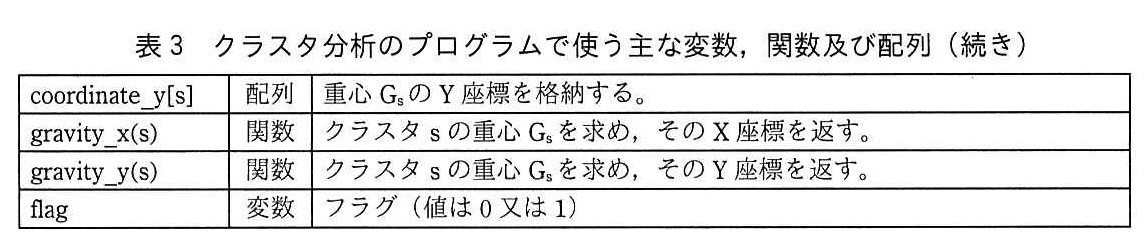
図の説明テキスト
表3 クラスタ分析のプログラムで使う主な変数,関数及び配列(続き)
| 名称 | 種類 | 内容 |
|---|---|---|
| coordinate_y[s] | 配列 | 重心のY座標を格納する。 |
| gravity_x(s) | 関数 | クラスタsの重心を求め,そのX座標を返す。 |
| gravity_y(s) | 関数 | クラスタsの重心を求め,そのY座標を返す。 |
| flag | 変数 | フラグ(値は 0 又は 1) |
図の説明テキスト
function clustering(N, K)                      //N はデータ数,K はクラスタ数
  MaxCount ← 100                               //無限ループを防ぐため最大見直し回数を設定
  initial(K)                                   //初期設定
  for( s を 1 から N まで 1 ずつ増やす )        //クラスタを決定(1 回目)
    for( t を 1 から K まで 1 ずつ増やす )
      data_length[t] ← data_dist(s, core[t])
    endfor
    cluster[s] ← min_index(data_length)
  endfor
  for( p を 1 から MaxCount まで 1 ずつ増やす )  //クラスタを見直す
    if( p が 1 と等しい )
      for( <span id="q3_blank_イ" class="blank-label">イ</span> )                              //1 回目の重心の計算
        coordinate_x[t] ← gravity_x(t)
        coordinate_y[t] ← gravity_y(t)
      endfor
    else
      <span id="q3_blank_ウ" class="blank-label">ウ</span>
      for( <span id="q3_blank_イ" class="blank-label">イ</span> )                              //2 回目以降の重心の計算
        if( gravity_x(t) と coordinate_x[t] が異なる      //重心を修正する
            又は gravity_y(t) と coordinate_y[t] が異なる )
          coordinate_x[t] ← gravity_x(t)
          coordinate_y[t] ← gravity_y(t)
          flag ← 1
        endif
      endfor
      if( <span id="q3_blank_エ" class="blank-label">エ</span> )                               //終了して抜ける
        return
      endif
    endif
    for( s を 1 から N まで 1 ずつ増やす )      //近い重心を見つける
      for( t を 1 から K まで 1 ずつ増やす )
        grav_length[t] ← grav_dist(s, t)
      endfor
      <span id="q3_blank_オ" class="blank-label">オ</span>
    endfor
  endfor
endfunction
〔初期設定の改良〕
このアルゴリズムの最終結果は初期設定に依存し,そこでのコア間の距離が短いと適切な分類結果を得にくい。そこで,関数 initial において一つ目のコアはランダムに選び,それ以降はコア間の距離が長くなる点が選ばれやすくなるアルゴリズムを検討した。検討したアルゴリズムでは, 番目までのコアが決まった後, 番目のコアを残った点から選ぶときに,それまでに決まったコアから離れた点を,より高い確率で選ぶようにする。具体的には,それまでに決まったコア(コア 1〜コア )と,残った 個の点から選んだ点 との距離の和を とする。 個の全ての点について を求め, が カ ほど高い確率で点 が選ばれるようにする。このとき,点 が 番目のコアとして選ばれる確率として キ を適用する。
設問と解答・解説
設問1
〔分類方法と例〕について,(1),(2)に答えよ。
図 1 中の ア に入れる座標を答えよ。
模範解答
(1.5,3)
採点基準
- 2点: クラスタ2の所属点から、X座標およびY座標の平均が正しく求められている。
- 1点: X座標またはY座標のいずれか片方のみが正しく計算されている。
- 0点: 対象となる点や重心の計算方法を誤っている。
- 2点: X座標とY座標が組となって、座標の形式で明確に記述されている。
- 1点: 値は求められているが、座標の形式として不完全な記述になっている。
- 0点: 座標としての形式を満たしていない。
解説
表1より、1回目のクラスタ分けでクラスタ2に所属する点は、 と である。
問題文の「(3) クラスタの重心を計算し…」より、重心のX座標はクラスタに含まれる点のX座標の平均、Y座標はY座標の平均と定義されている。
の座標は 、 の座標は である。
- X座標の平均:
- Y座標の平均:
したがって、クラスタ2の重心 の座標は (1.5, 3) となる。
高得点のポイント
- クラスタ2に所属する点が と であることを正確に把握できているか。
- 重心の定義に従い、X座標とY座標の平均値を正しく計算できているか。
- 座標の形式
(X, Y)に則って正しく記述できているか。
図 1 中の下線①のように分類が完了したときに, と同じクラスタに入る点を全て答えよ。
模範解答
P2,P3,P7
採点基準
- 2点: 2回目の重心計算結果に基づき、$P_2$、$P_3$、$P_7$ がクラスタ1に所属することを正確に見極めている。
- 1点: 所属点の判定に一部誤りがあるが、見直しの手順自体は概ね理解している。
- 0点: 重心の再計算や距離の比較が正しく行えていない。
- 2点: 該当する全ての点($P_2, P_3, P_7$)を漏れなく、かつ余分な点を含まずに解答している。
- 1点: 該当する点の一部が欠けている、あるいは誤った点が1つ混ざっている。
- 0点: 指定された条件を満たす点を論理的に導出できていない。
解説
表2より、1回目の重心の見直し(手順(4))で各点の「次の所属クラスタ番号」は以下のようになっている。
- クラスタ1:, , ,
- クラスタ2:, ,
手順(5)に従い、再度重心を計算(手順(3))する。
- クラスタ1の重心
- X座標の平均:
- Y座標の平均:
- よって
- クラスタ2の重心
- X座標の平均:
- Y座標の平均:(約2.67)
- よって
次に、各点と新しい重心との距離を比較(手順(4))する。
- :との距離の2乗 。との距離の2乗 。よって が近いのでクラスタ1。
- :との距離の2乗 。との距離の2乗 。よって が近いのでクラスタ1。
- :との距離の2乗 。との距離の2乗 。よって が近いのでクラスタ1。
- :との距離の2乗 。との距離の2乗 。よって が近いのでクラスタ2。
- :のX座標は に近く、Y座標も より明らかに近いためクラスタ2。
- :のX座標は に近く、Y座標も より明らかに近いためクラスタ2。
- :との距離の2乗 。との距離の2乗 。よって が近いのでクラスタ1。
各点の所属クラスタが前回と変わらないため、重心の座標も変わらなくなり、分類が完了する。
最終的に と同じクラスタ1に入るのは、、、 である。
高得点のポイント
- 2回目の重心座標を正しく計算できているか。
- 計算した重心との距離を比較し、各点の新しい所属クラスタを正しく判定できているか。
- 所属クラスタが変わらないことを確認し、最終的なクラスタ1の要素を漏れなく解答できているか。
設問1(2)は,正答率がやや低かった。表2の結果を使い,重心とクラスタの見直しを繰り返し,座標が変わらなくなるまで,落ち着いて計算して正答を導き出してほしい。
図 2 中の イ に入れる適切な字句を答えよ。
模範解答
tを1からKまで1ずつ増やす
採点基準
- 1点: 変数tを用いて、1からKまでのすべてのクラスタに対して重心計算のループを行うことが示されている。
- 0点: ループの対象や範囲が誤っている。
- 1点: 「〜を〜から〜まで1ずつ増やす」という図2内の他のfor文と同様の構文で論理的に記述されている。
- 0点: 構文が不適切であり、プログラムとしての論理構造にそぐわない。
解説
図2のプログラム関数 clustering の中盤にある、「1回目の重心の計算」と「2回目以降の重心の計算」のループ条件(イ)について考える。
表3より、関数 gravity_x(s) は「クラスタsの重心を求め,そのX座標を返す」関数であり、gravity_y(s) は同様にY座標を返す関数である。
プログラム内では coordinate_x[t] ← gravity_x(t) のように呼び出されており、変数 t はクラスタの番号を表している。
問題の分類方法(3)に「 個のクラスタのそれぞれについて…」とある通り、重心の計算はすべてのクラスタ(1 から まで)に対して行う必要がある。
プログラム内の他の for ループ(例:for( t を 1 から K まで 1 ずつ増やす ))の記述構文に倣うと、イには t を 1 から K まで 1 ずつ増やす が入る。
高得点のポイント
- 重心計算の対象が全クラスタ(1から )であることを理解できているか。
- プログラム中の他のループ処理の構文(「〜を〜から〜まで1ずつ増やす」)に合わせて正確に記述できているか。
図 2 中の ウ に入れる適切な字句を答えよ。
模範解答
flag ← 0
採点基準
- 1点: ループ処理に入る前に、変化の有無を記録するフラグ変数 flag を初期化する意図が示されている。
- 0点: フラグ変数の初期化の意図が示されていない。
- 1点: 「flag ← 0」のように、変数に対する適切な初期値の代入文として記述されている。
- 0点: 代入文の形式として不適切である。
解説
図2のプログラムにおいて、変数 flag は「重心を修正する」処理の中で、座標が変化した場合に 1 が代入されている。
これは、重心の座標が変わったかどうかを判定するためのフラグである。
ウは、「2回目以降の重心の計算」を行う for ループの直前に位置している。
ここでは、各クラスタの重心計算と変更判定(gravity_x(t) と coordinate_x[t] の比較)を行う前に、事前にフラグをリセットしておく必要がある。
もし座標の変化が一つもなければ flag は初期化された値のままとなり、その後のエの判定で「終了して抜ける」処理へ進むことができる。
したがって、変化があった場合に 1 となる flag は、ループに入る前のウで 0 に初期化(代入)しなければならない。
解答は flag ← 0 となる。
高得点のポイント
- 変数
flagが重心変化の有無を記録するフラグであることを理解できているか。 - ループ開始前にフラグを初期化する代入文
flag ← 0を正しく記述できているか。
図 2 中の エ に入れる適切な字句を答えよ。
模範解答
flagが0と等しい
採点基準
- 1点: 重心の座標が変わらなかった場合(フラグが変化しなかった場合)に終了するという条件を正確に把握している。
- 0点: 終了条件の理解が誤っている。
- 1点: 「flagが0と等しい」など、等価性を判定する適切な条件式の構文で記述されている。
- 0点: 条件式の構文として不適切である。
解説
図2のプログラム中のエは、「終了して抜ける」ための条件を判定する if 文の条件式である。
問題文の分類方法(5)に「重心の座標が変わらなくなるまで、(3)と(4)を繰り返す」とある。
ウの直後のループ処理内で、重心の座標が前回と異なる(修正された)場合には flag ← 1 が実行される。
逆に、すべてのクラスタで重心の座標が変わらなかった場合、flag はウで初期化された 0 のままとなる。
したがって、アルゴリズムが終了する条件は「重心の座標が変わらなかった場合」、つまり flag が 0 であることとなる。
よって、エには flagが0と等しい が入る。
高得点のポイント
- k-means法の終了条件が「重心の座標が変わらないこと」であることを理解できているか。
- フラグ変数
flagの値を用いて、終了判定の条件式(「〜が〜と等しい」)を適切に記述できているか。
図 2 中の オ に入れる適切な字句を答えよ。
模範解答
cluster[s] ← min_index(grav_length)
採点基準
- 1点: 関数 min_index の引数として、重心との距離を格納した配列 grav_length を正しく指定できている。
- 0点: 関数の引数指定や対象配列の理解が誤っている。
- 1点: 得られたクラスタ番号を配列 cluster[s] に代入する形式で論理的に記述されている。
- 0点: 代入先の指定や文の構造が不適切である。
解説
図2のプログラム中のオは、「近い重心を見つける」処理の内部で、点 が次に所属するクラスタ番号を決定する処理である。
直前の for ループ内で、点 と各クラスタの重心 との距離が grav_dist(s, t) で計算され、配列 grav_length[t] に格納されている。
分類方法(4)に「各点から見て距離が最も短い重心(複数存在する場合は、番号が最も小さい重心)を選ぶ。選ばれた重心の番号を、各点が所属する次のクラスタ番号とする」とある。
表3の関数 min_index() は「配列の中で,最小値が格納されている添字sを返す」ものであり、これを活用する。
1回目のクラスタ決定の処理(cluster[s] ← min_index(data_length))と同様に、重心との距離が格納された grav_length を min_index() の引数として渡し、その結果(最短距離となるクラスタ番号)を cluster[s] に格納すればよい。
したがって、オには cluster[s] ← min_index(grav_length) が入る。
高得点のポイント
- 各点から最も近い重心のクラスタ番号を取得する関数
min_indexの使い方を理解できているか。 - 引数として適切な配列
grav_lengthを指定し、結果をcluster[s]に代入する式を正しく構成できているか。
設問3
〔初期設定の改良〕について,(1),(2)に答えよ。
本文中の カ に入れる適切な字句を解答群の中から選び,記号で答えよ。
模範解答
選択肢ア: 大きい
解説
問題文の〔初期設定の改良〕において、「それまでに決まったコアから離れた点を、より高い確率で選ぶ」アルゴリズムの検討が行われている。
「それまでに決まったコア(コア 1〜コア )と,残った 個の点から選んだ点 との距離の和を とする」と定義されているため、 が大きいほど、その点 は既存のコアから離れていることになる。
目的は「離れた点を、より高い確率で選ぶ」ことであるため、 の値が「大きい」ほど高い確率で選ばれるように設定すればよい。
したがって、カには「大きい」が入る。正解は ア である。
各選択肢の解説
- ア (大きい): 正解。距離の和 が大きいほど既存のコアから離れているため、改良の目的に合致する。
- イ (小さい): 距離の和 が小さい点は既存のコアに近い点である。これを選びやすくすると「コア間の距離が短いと適切な分類結果を得にくい」という課題を解決できず、誤りである。
本文中の キ に入れる適切な式を と を使って答えよ。
ここで, は 個の全ての の和とする。
模範解答
Ts/Sum
採点基準
- 1点: 個別の距離の和と全体の和の比によって確率が求まることを理解している。
- 0点: 確率の計算方法についての理解が誤っている。
- 1点: 変数 $T_s$ と $Sum$ を用いて、割り算の形式で正しく数式が構成されている。
- 0点: 変数の使い方が誤っている、または数式の構造が不適切である。
解説
問題文より、点 が選ばれる確率は、距離の和 が大きいほど高くなるように設定する。
具体的には、 に比例する確率分布を考える。
確率の基本性質として、すべての選択肢(残った 個のすべての点)が選ばれる確率の合計は 1(100%)にならなければならない。
各点の の値に比例し、かつ総和が 1 になるような確率を求めるには、各点の を「すべての の総和」で割ればよい。
問題文では、 個の全ての の和を と定義している。
したがって、点 が選ばれる確率は、 を で割った (または )という式になる。
高得点のポイント
- 確率の総和が 1 になるという基本的な性質を理解できているか。
- 距離の和 に比例する確率を、全体の和 を用いた比(割り算)として正しく数式化できているか。
設問3は,正答率がやや高かった。問題文から,各点と既存コアの距離をベースにした確率分布を用いていることが分かるので,確率をTS/Sumとすればよい。これによって,総和が1になるなどの確率の基本性質に合致することを理解してほしい。